AI-in-a-Box
L'IA d'entreprise on-premise, entièrement gérée.
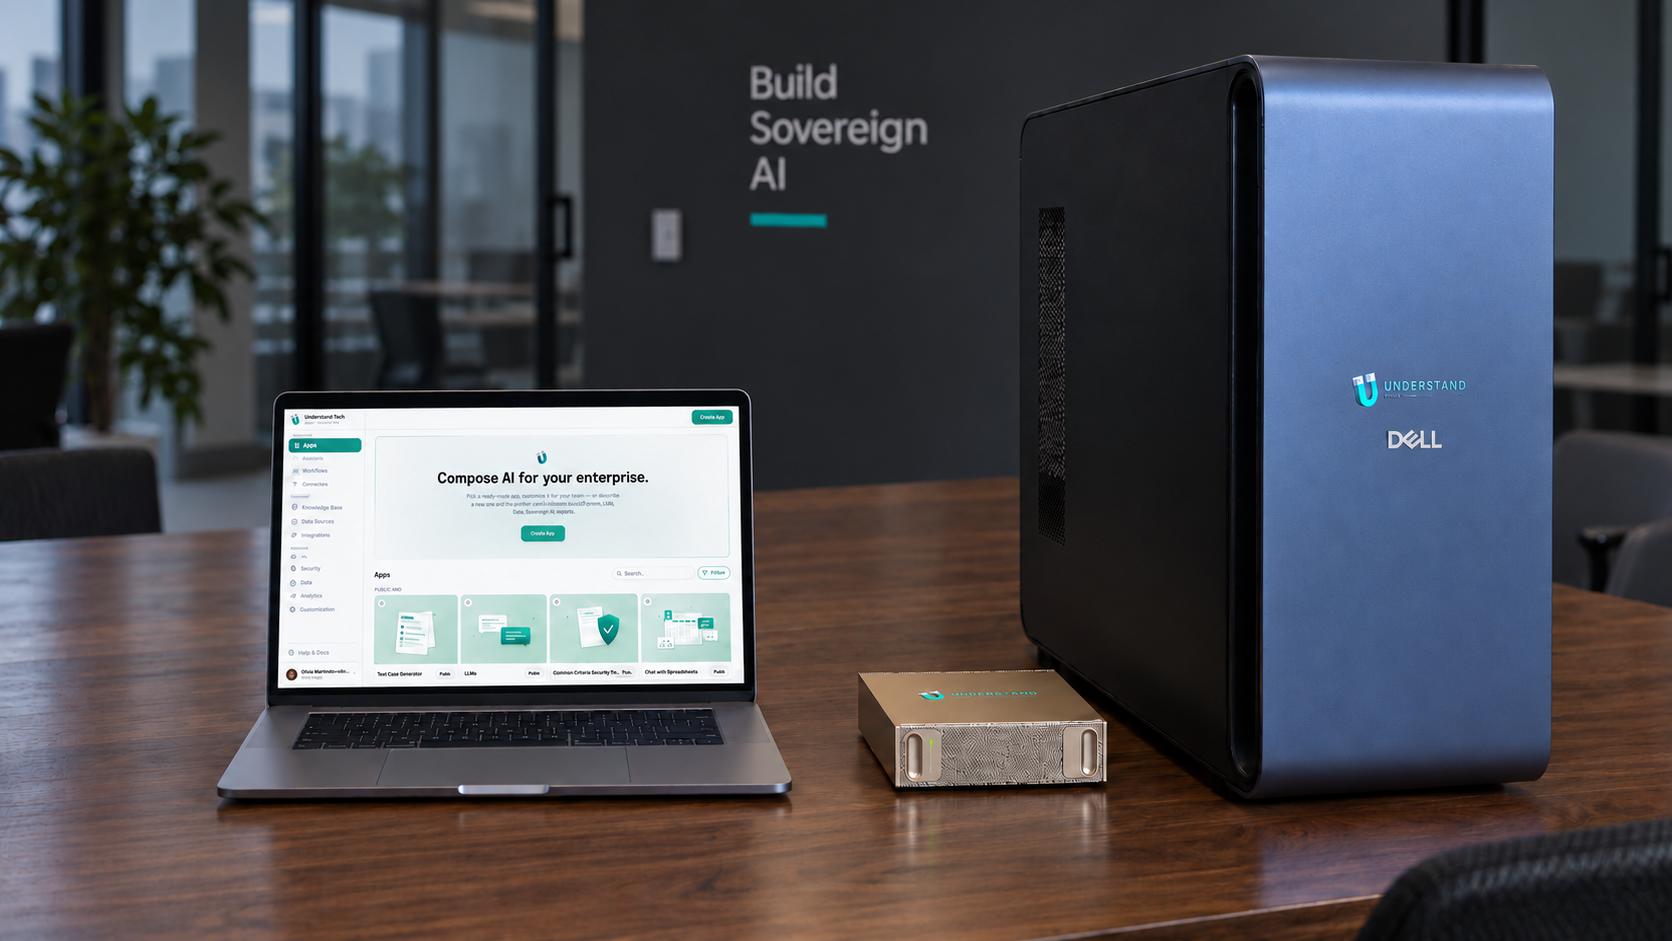
Déployez la plateforme Understand Tech dans votre propre infrastructure (compatible air-gap) pour exécuter LLM locaux, RAG et workflows avec une gouvernance de niveau entreprise, sans dépendance au cloud.
L'IA d'entreprise on-premise, à l'intérieur de vos propres locaux.
Tout ce dont vos équipes ont besoin est livré dans la box
Exécution locale
Aucun appel sortant. Aucune dépendance au cloud. Aucune limite de tokens.
LLM locaux
Modèles open source dans la box. Aucune facture au token.
Assistants
Réponses sourcées depuis vos documents. Rien n'est téléversé.
Agents de code
Votre code ne sort jamais. Aucune limite de tokens.
Workflows
Automatisez des tâches multi-étapes, en local et sans supervision.
Understand Studio
Créez vos apps IA. Sans développeurs, sans code.
Apps prêtes à l'emploi
Générateur de cas de test, chat avec CSV et plus, préinstallés.
Voir toute la marketplaceAucun appel sortant. Aucune dépendance au cloud. Aucune limite de tokens.
LLM locaux
Modèles open source dans la box. Aucune facture au token.
Assistants
Réponses sourcées depuis vos documents. Rien n'est téléversé.
Agents de code
Votre code ne sort jamais. Aucune limite de tokens.
Workflows
Automatisez des tâches multi-étapes, en local et sans supervision.
Understand Studio
Créez vos apps IA. Sans développeurs, sans code.
Apps prêtes à l'emploi
Générateur de cas de test, chat avec CSV et plus, préinstallés.
Voir toute la marketplaceDe la livraison à la production en 30 minutes
Déballez l'appliance
En rack ou sur un bureau, branchez l'alimentation et votre réseau.
Deux générations : GB10 et GB300
Plateformes NVIDIA Grace Blackwell de classe datacenter, livrées comme une appliance souveraine, on-premise et air-gapped. Deux formats, dimensionnés pour une équipe ou pour toute une organisation.
GB10
NVIDIA GB10 · classe DGX Spark
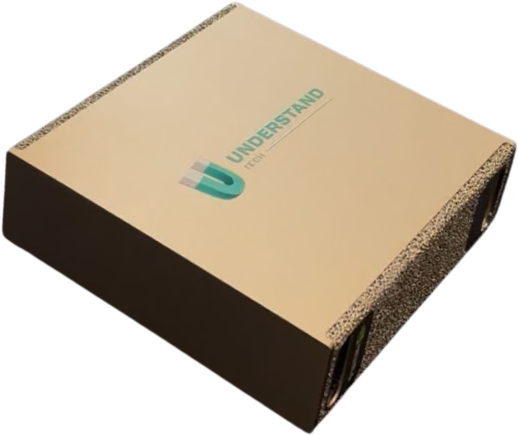
1 PFLOP
IA (FP4)
128 Go
Mém. unifiée
~200 Md
Params. modèle
- Architecture NVIDIA Grace Blackwell
- CPU Arm 20 cœurs · 273 Go/s de bande passante mémoire
- Réseau ConnectX-7, 10 GbE et Wi-Fi 7
- Format bureau, pour une équipe de plusieurs dizaines de personnes
- 100 % hors-ligne / compatible air-gap
GB300
NVIDIA GB300 · classe DGX Station
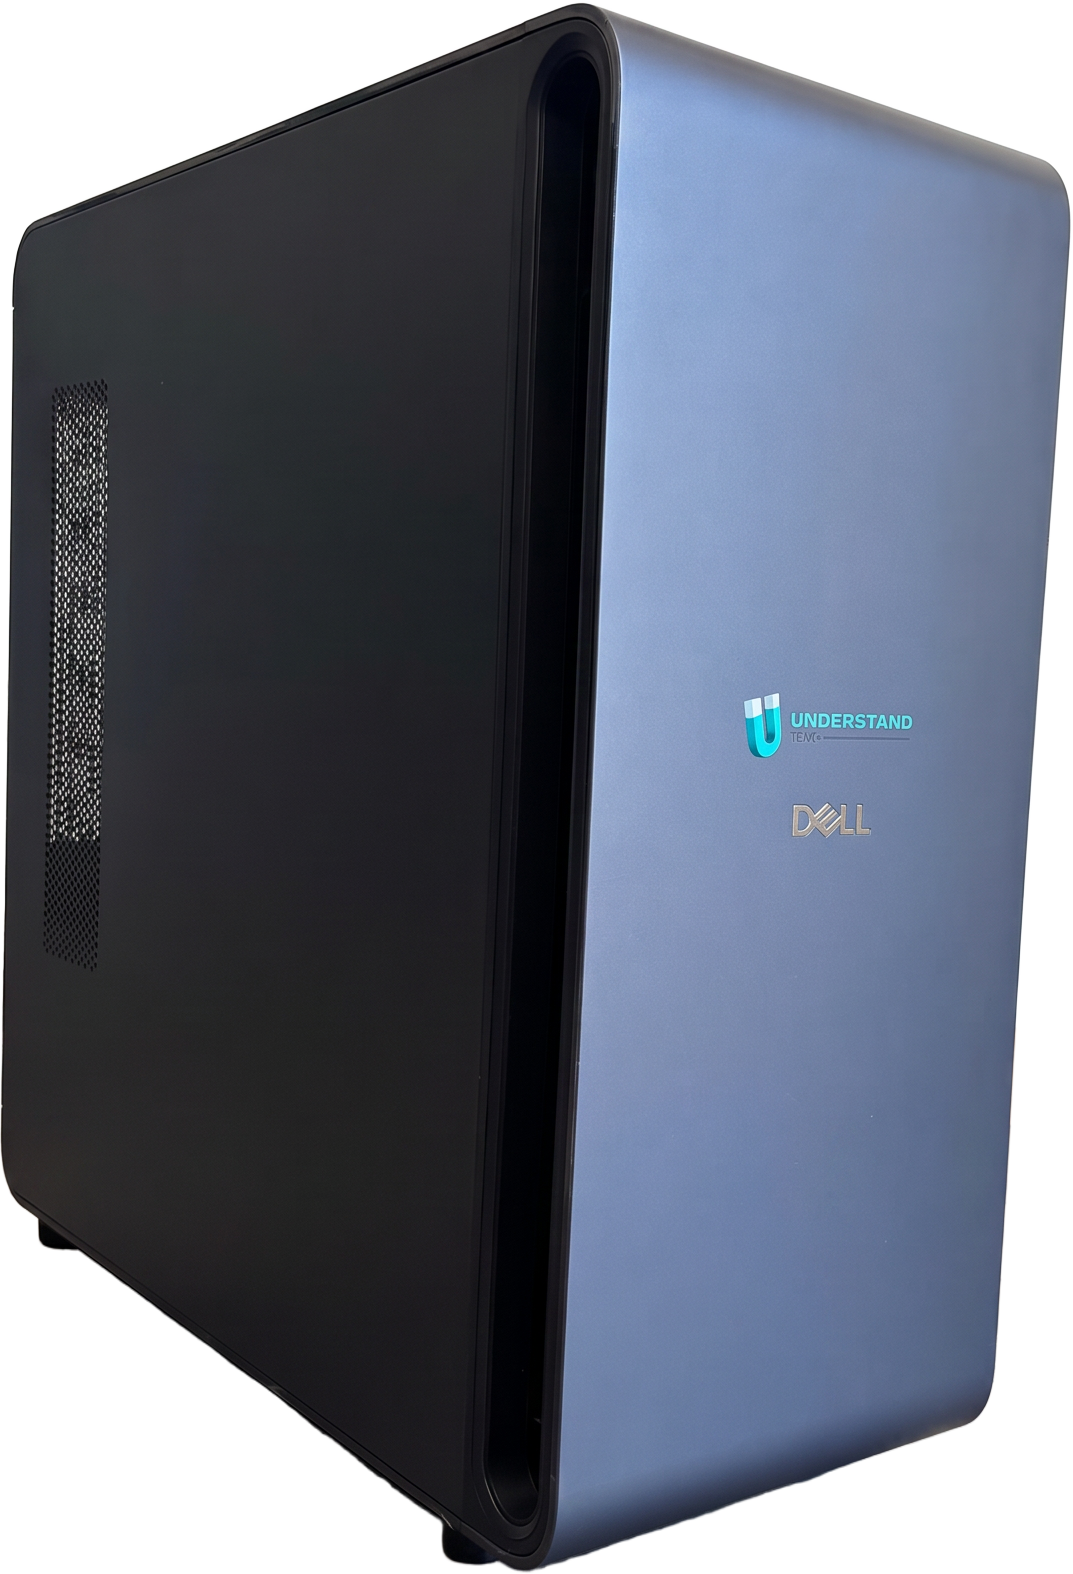
20 PFLOPS
IA (FP4)
784 Go
Mém. unifiée
~1 000 Md
Params. modèle
- Superchip NVIDIA Grace Blackwell Ultra · Tensor Cores 5ᵉ génération
- CPU Grace 72 cœurs (Arm Neoverse) · bande passante GPU jusqu'à 8 To/s
- 288 Go HBM3e + 496 Go LPDDR5X en mémoire cohérente
- ConnectX-8 SuperNIC · 800 Gb/s · SSD NVMe 16 To
- 500+ utilisateurs simultanés · station tour de classe datacenter
Comparatif matériel complet
Même plateforme, même stack logicielle. Choisissez votre échelle.
Afficher les spécificationsMasquer les spécifications
Comparatif matériel complet
Même plateforme, même stack logicielle. Choisissez votre échelle.
Pour les équipes
GB10
NVIDIA GB10 · classe DGX Spark
Pour les organisations
GB300
NVIDIA GB300 · classe DGX Station
Spécifications préliminaires basées sur les informations plateforme publiées par NVIDIA ; les chiffres définitifs seront confirmés au lancement. Consommation électrique, acoustique, thermique et spécifications mécaniques détaillées dépendent du système NVIDIA / OEM retenu, se référer à la fiche technique matérielle de l'OEM pour ces paramètres.
Ce qui est inclus
Matériel
Appliance GPU certifiée NVIDIA
Calcul, mémoire, stockage et réseau préprovisionnés, livrés prêts à installer.
Inférence locale accélérée par GPU
Modèles open source exécutés localement, avec contrôle d'accès par modèle et allow-list optionnelle pour les LLM publics.
Stack de production préconfiguré
Interface, APIs, workers, runtime LLM et base de données/file de messages, déployés au sein de votre réseau.
Logiciel & Licence
Licence plateforme entreprise
Plateforme multi-utilisateurs avec console d'administration : assistants, workflows, RAG et APIs.
Sécurité & Gouvernance
RBAC, journaux d'audit, stockage local chiffré, intégration KMS/HSM optionnelle.
Mises à jour OTA et correctifs
Nous assurons les mises à jour à distance (OTA) de l'appliance : nouvelles versions de la plateforme, mises à jour des modèles, correctifs de sécurité et contrôles d'intégrité. Livraison hors ligne possible pour les sites isolés.
Déploiement & Mise en service
Réception, installation, configuration et formation initiale des administrateurs (à distance ou sur site).
Sauvegardes & Restauration
Sauvegardes automatisées avec politique de rétention et procédures de restauration documentées.
Comment ça fonctionne
Toute la puissance de la plateforme Understand Tech, entièrement à l'intérieur de votre périmètre physique.
Architecture
AI-in-a-Box
Stack intégré
Sources de données
Docs • Bases • SharePoint • Drive
Plateforme logicielle
Assistants • RAG • Workflows
Sécurité & Gouvernance
SSO • RBAC • Journaux d'audit • Chiffrement
Mises à jour OTA
Correctifs • Supervision • Support
Sources de données
Docs • Bases • SharePoint • Drive
Plateforme logicielle
Assistants • RAG • Workflows
AI-in-a-Box
Stack intégré
Sécurité & Gouvernance
SSO • RBAC • Journaux d'audit • Chiffrement
Mises à jour OTA
Correctifs • Supervision • Support
Vos données entrent. Tout s'exécute à l'intérieur de votre périmètre.
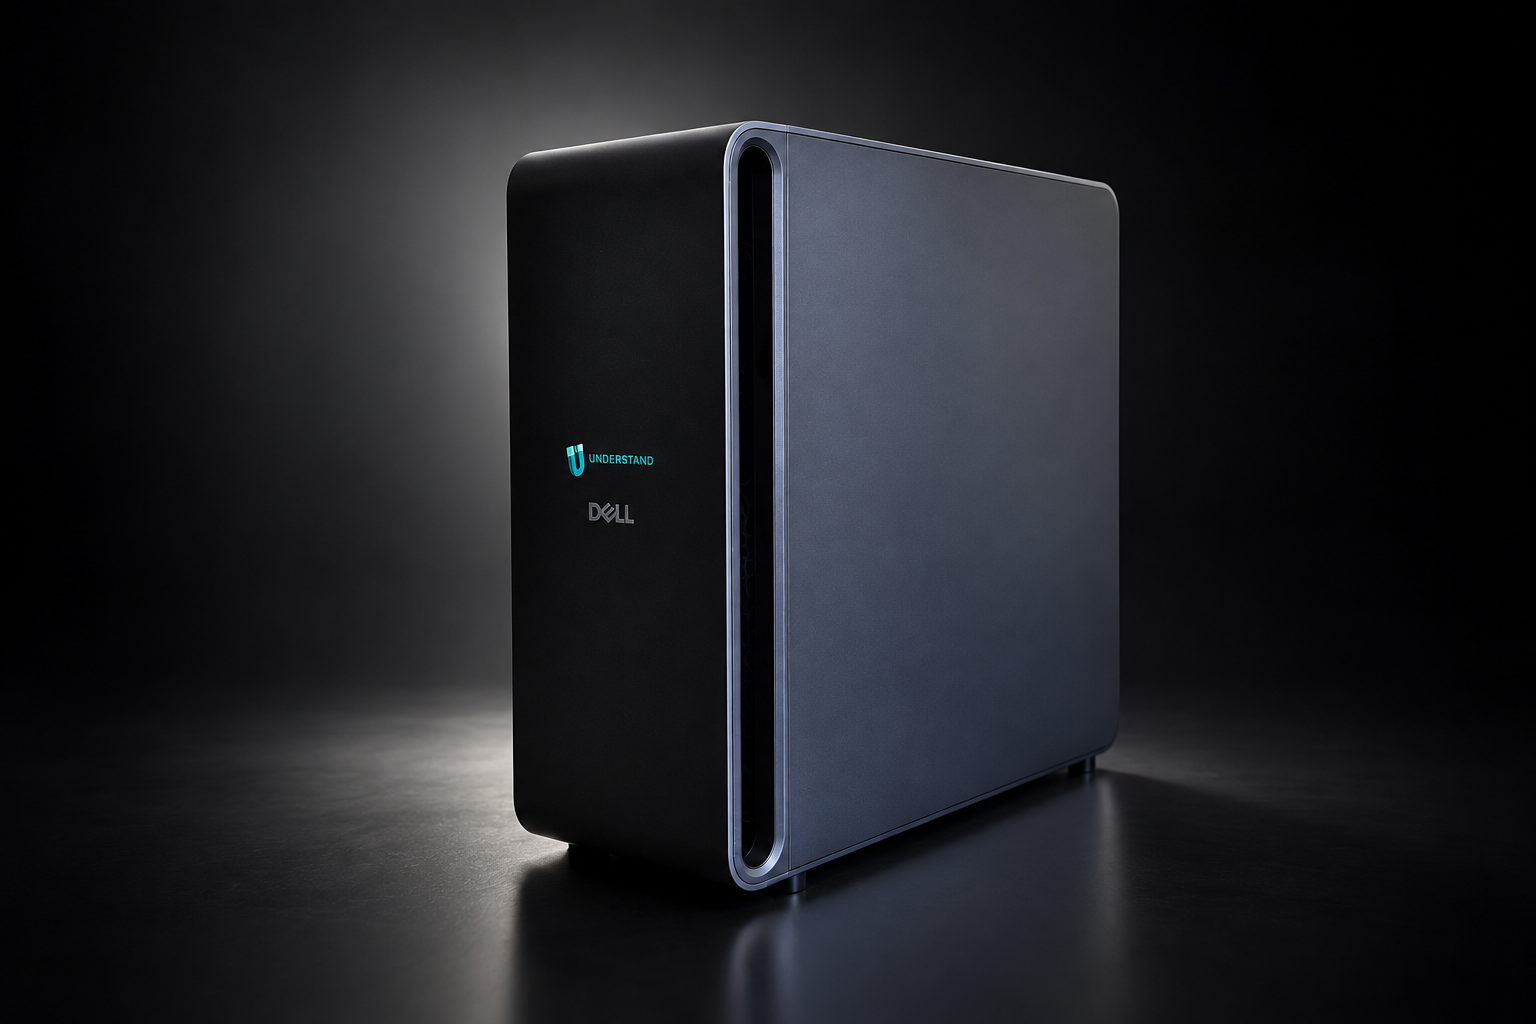
L'appliance
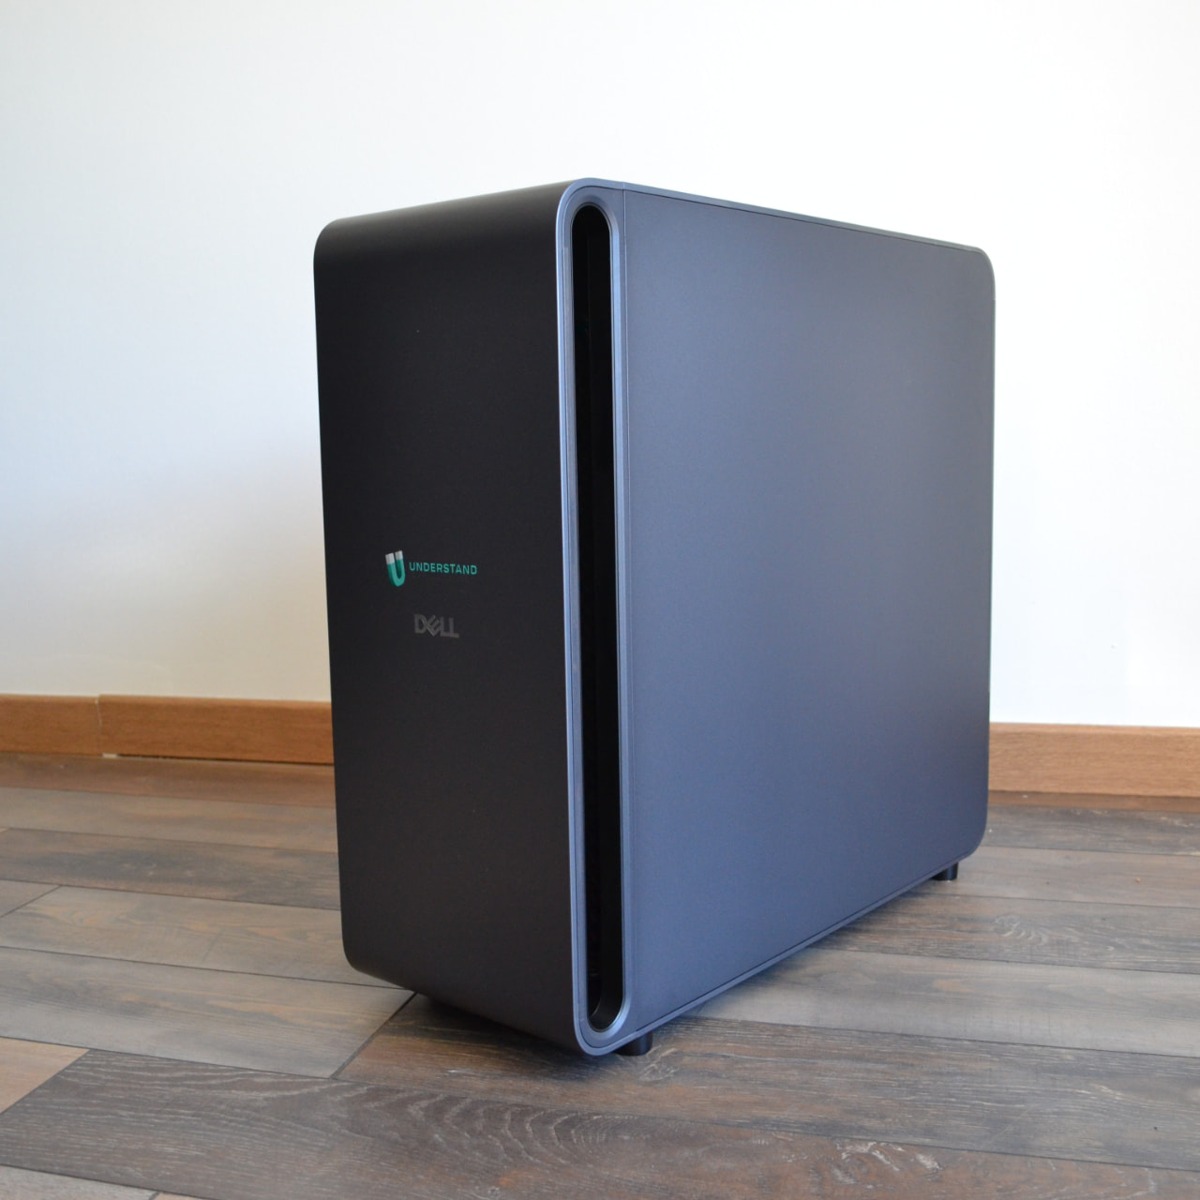
Livrée préconfigurée. Branchez-la, vos données restent sur site.
Ressources & documentation
Tout ce dont vos équipes IT, Sécurité et Achats ont besoin pour évaluer et déployer.
Dépôt GitHub
Images Docker, scripts de déploiement et releases taguées. Clonez, pullez et déployez.
Prêt pour Docker ComposePrise en main / Guide utilisateur
Installation pas à pas, configuration, onboarding admin et documentation d'usage de la plateforme.
docs.understand.tech
Guide d'installation et de configuration
Suivez Clara pas à pas dans l'installation et la configuration d'AI-in-a-Box.
Comment les entreprises l'utilisent aujourd'hui.
Quand le cloud n'est pas une option, AI-in-a-Box amène toutes les capacités d'IA d'entreprise à l'intérieur de votre périmètre.
Automatisation des tests silicium
Des agents rédigent les cas de test de puces, les exécutent sur du matériel réel et évaluent les résultats sous supervision humaine. Des semaines de validation manuelle condensées en une seule boucle guidée.

Comptabilité & Juridique
Traitement de documents, extraction de chiffres, rédaction et recherche de connaissances sur vos propres dossiers. Plus des applications sur mesure créées dans Understand Studio.
Lire le cas d'usage CerFrance
Assistants internes sécurisés
Incirt exécute ses assistants de connaissance entièrement sur l'appliance : aucun coût de tokens, aucun comptage par utilisateur, et une propriété intellectuelle qui ne quitte jamais le périmètre.
Infrastructures critiques
Énergie, utilities et systèmes de contrôle industriels qui ne peuvent pas être connectés à des réseaux externes.
Génération de code
Agents de code exécutés entièrement sur l'appliance, sans limite de tokens.
Brevets & R&D
Rédaction confidentielle et recherche, sans aucun service externe à l'exécution.
Quel est le vrai coût ?
Comparez la construction de votre propre stack IA on-premise au déploiement d'AI-in-a-Box.
| Option | Matériel | Logiciel + dev | Maintenance | Ressources humaines | Total sur 3 anssur 3 ans |
|---|---|---|---|---|---|
| Construire soi-mêmeLe matériel est un coût unique. Logiciel, maintenance et personnel sont annuels, multipliés par 3.3 à 12 mois de déploiement, aucun SLA. | k€ Coût unique | k€ Par an | k€ Par an | k€ Par an | 239 k€ |
| AI-in-a-Box · NVIDIA GB10Abonnement tout compris, opérationnel dès J1.Mises à jour signées air-gap, SLA éditeur. | Inclus | Inclus | Inclus | Inclus | 75 000 €25 000 € / anÉconomie 69 % |
Tarifs du marché européen. Le GB300 démarre à 150 000 € par an et reste confirmé sur devis selon la configuration.
Les tarifs en bref
Tout compris : appliance, licence de la plateforme, modèles, mises à jour et support.
Pourquoi AI-in-a-Box
Comparez l'on-premise aux solutions 100 % cloud.
Spécifications techniques
Une plateforme d'IA complète et autonome, déployée et exploitée sur votre infrastructure.
Modèle de déploiement
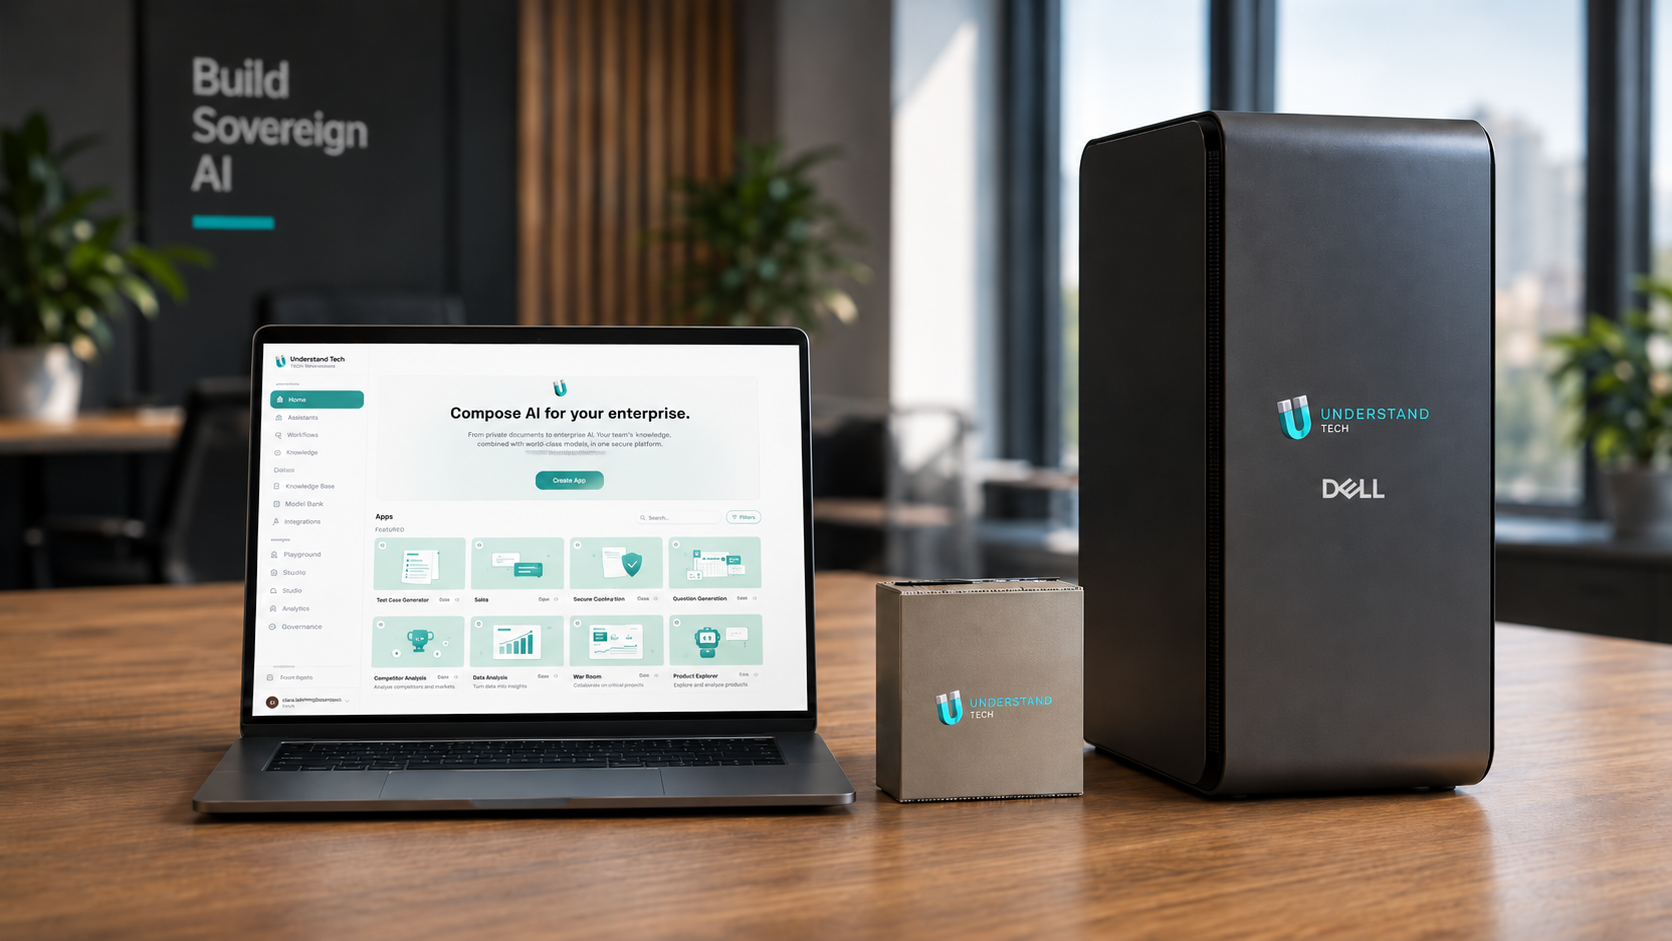
- Stack auto-hébergée déployée via Docker Compose sur un système GPU de classe NVIDIA
- URL d'accès : https://understand.local (mDNS) avec fallback IP si mDNS est bloqué
- Local-first : plateforme entièrement dans le réseau client, sans dépendance au cloud
Services principaux inclus
- Interface web (admin + utilisateurs finaux)
- Couche API (plateforme + API client/partenaire quand activée)
- Runtime LLM avec accélération GPU
- Workers d'arrière-plan pour ingestion, workflows et traitements par lot
- MongoDB (données persistantes) + Redis (queues/cache)
- Reverse proxy + HTTPS (TLS interne ; auto-signé par défaut)
LLM pris en charge
- NVIDIA Nemotron par défaut, servi via NVIDIA NIM (Nemotron 3.5 Lightning sur GB10 ; Nemotron 3 Super / Ultra sur GB300)
- Modèles open-weight pris en charge : GPT-OSS-20B / 120B, Qwen3.8 (27B, Flash-Next), DeepSeek-V4-Flash, GLM-5.3-Flash
- GB10 : 128 Go de mémoire unifiée. GB300 : 784 Go de mémoire cohérente, modèles jusqu'à ~1 000 Md de paramètres
- Mode hybride : ajoutez vos propres clés API pour des fournisseurs externes, ou restez 100 % local sans appel sortant
- Les administrateurs choisissent les modèles autorisés par équipe et par application
Identité & Administration
- Contrôle admin complet des utilisateurs, workspaces, assistants, workflows et modèles autorisés
- Compatible SSO : s'intègre avec les fournisseurs d'identité d'entreprise
- Contrôle d'accès basé sur les rôles et journalisation prête pour l'audit
Stockage & Souveraineté des données
- Toutes les données stockées localement sur le matériel client
- Stockage local chiffré pour documents, embeddings et journaux
- Intégration optionnelle avec des politiques KMS/HSM (quand requis)
Réseau & Isolation
- Réseau backend isolé (communications service-à-service internes)
- Conçu pour les environnements restreints ; peut fonctionner sans accès Internet
- mDNS (understand.local) pris en charge ; réseaux d'entreprise en accès IP
Performance & Scalabilité
- Inférence accélérée par GPU de classe NVIDIA
- Support multi-utilisateurs simultanés (workers et services scalables)
- Scaling horizontal pour le débit, par ex. plus de workers pour davantage de jobs
Mises à jour & Maintenance
- Cycle de vie logiciel géré : mises à jour, correctifs et health checks
- Prise en charge de workflows de mise à jour hors ligne pour les environnements air-gapped
- Séparation claire : Understand Tech fournit le logiciel + le support ; le client exploite l'infrastructure
Observabilité & Diagnostic
- Outillage Docker standard : statut, health checks, usage des ressources
- Journaux par service (API, LLM, workers, base de données, proxy)
- Gestion GUI optionnelle via Portainer (local)
- Rotation des logs intégrée + politique d'archivage recommandée
Sauvegardes & Restauration (MongoDB)
- Sauvegardes automatisées et planifiées avec compression et rétention
- Procédures de restauration prises en charge (assistées et manuelles)
- Workflows de copie hors site pris en charge (contrôlés par le client)
Installation : premier déploiement en ~20 minutes en général (plus le téléchargement initial des images)
Note : AI-in-a-Box est une solution d'IA définie par logiciel d'Understand Tech, déployée sur du matériel certifié NVIDIA. Le matériel, les pilotes et le firmware NVIDIA sont fournis selon les conditions et garanties applicables de NVIDIA.
AI-in-a-Box FAQ
Tout ce qu'il faut savoir avant de déployer l'IA dans votre périmètre.
Généralités
Sécurité, confidentialité et conformité
Modèles et capacités LLM
Plateforme, fonctionnalités et intégrations
Déploiement, exploitation et mises à jour
Matériel et dimensionnement
Tarification et abonnement
Prêt à déployer l'IA à l'intérieur de votre périmètre ?
Obtenez un devis personnalisé ou téléchargez les documents à partager avec votre équipe.